
从零开始深入理解 AI Infra 的核心全栈技术
在线浏览:https://caomaolufei.github.io/AIInfraGuide/ | 更新日志
本项目系统梳理 AI Infra 的技术栈,从 GPU 硬件、CUDA 编程与算子优化,到分布式训练和推理优化,帮助工程师建立完整的 AI 基础设施知识体系。另设面试宝典板块,收录 180+ 场面试真题,覆盖 60+ 家公司。
快速导航: 学习路线 · 前置知识 · CUDA 编程与算子优化 · 分布式训练 · 推理优化 · 面试宝典 · 本地运行 · 参与贡献


AI 基础设施(AI Infra)支撑着大模型的训练、推理和服务。这个领域技术迭代很快,系统化的中文学习资料却不多。
很多工程师在学习 AI Infra 时面临相似的困境:
- CUDA 编程的入门资料散落各处,缺乏从基础到算子优化的完整路径
- 分布式训练涉及 DDP、FSDP、3D 并行等众多概念,不知道该从哪里开始
- 推理优化技术(PagedAttention、量化、Speculative Decoding)发展迅猛,难以跟上节奏
- 性能分析工具(Nsight Systems、Nsight Compute)功能强大,但上手门槛不低
AIInfraGuide 是一个开源、系统、面向实践的 AI Infra 知识库,按模块把这些内容串成一条从硬件到软件、从训练到推理的学习路径。
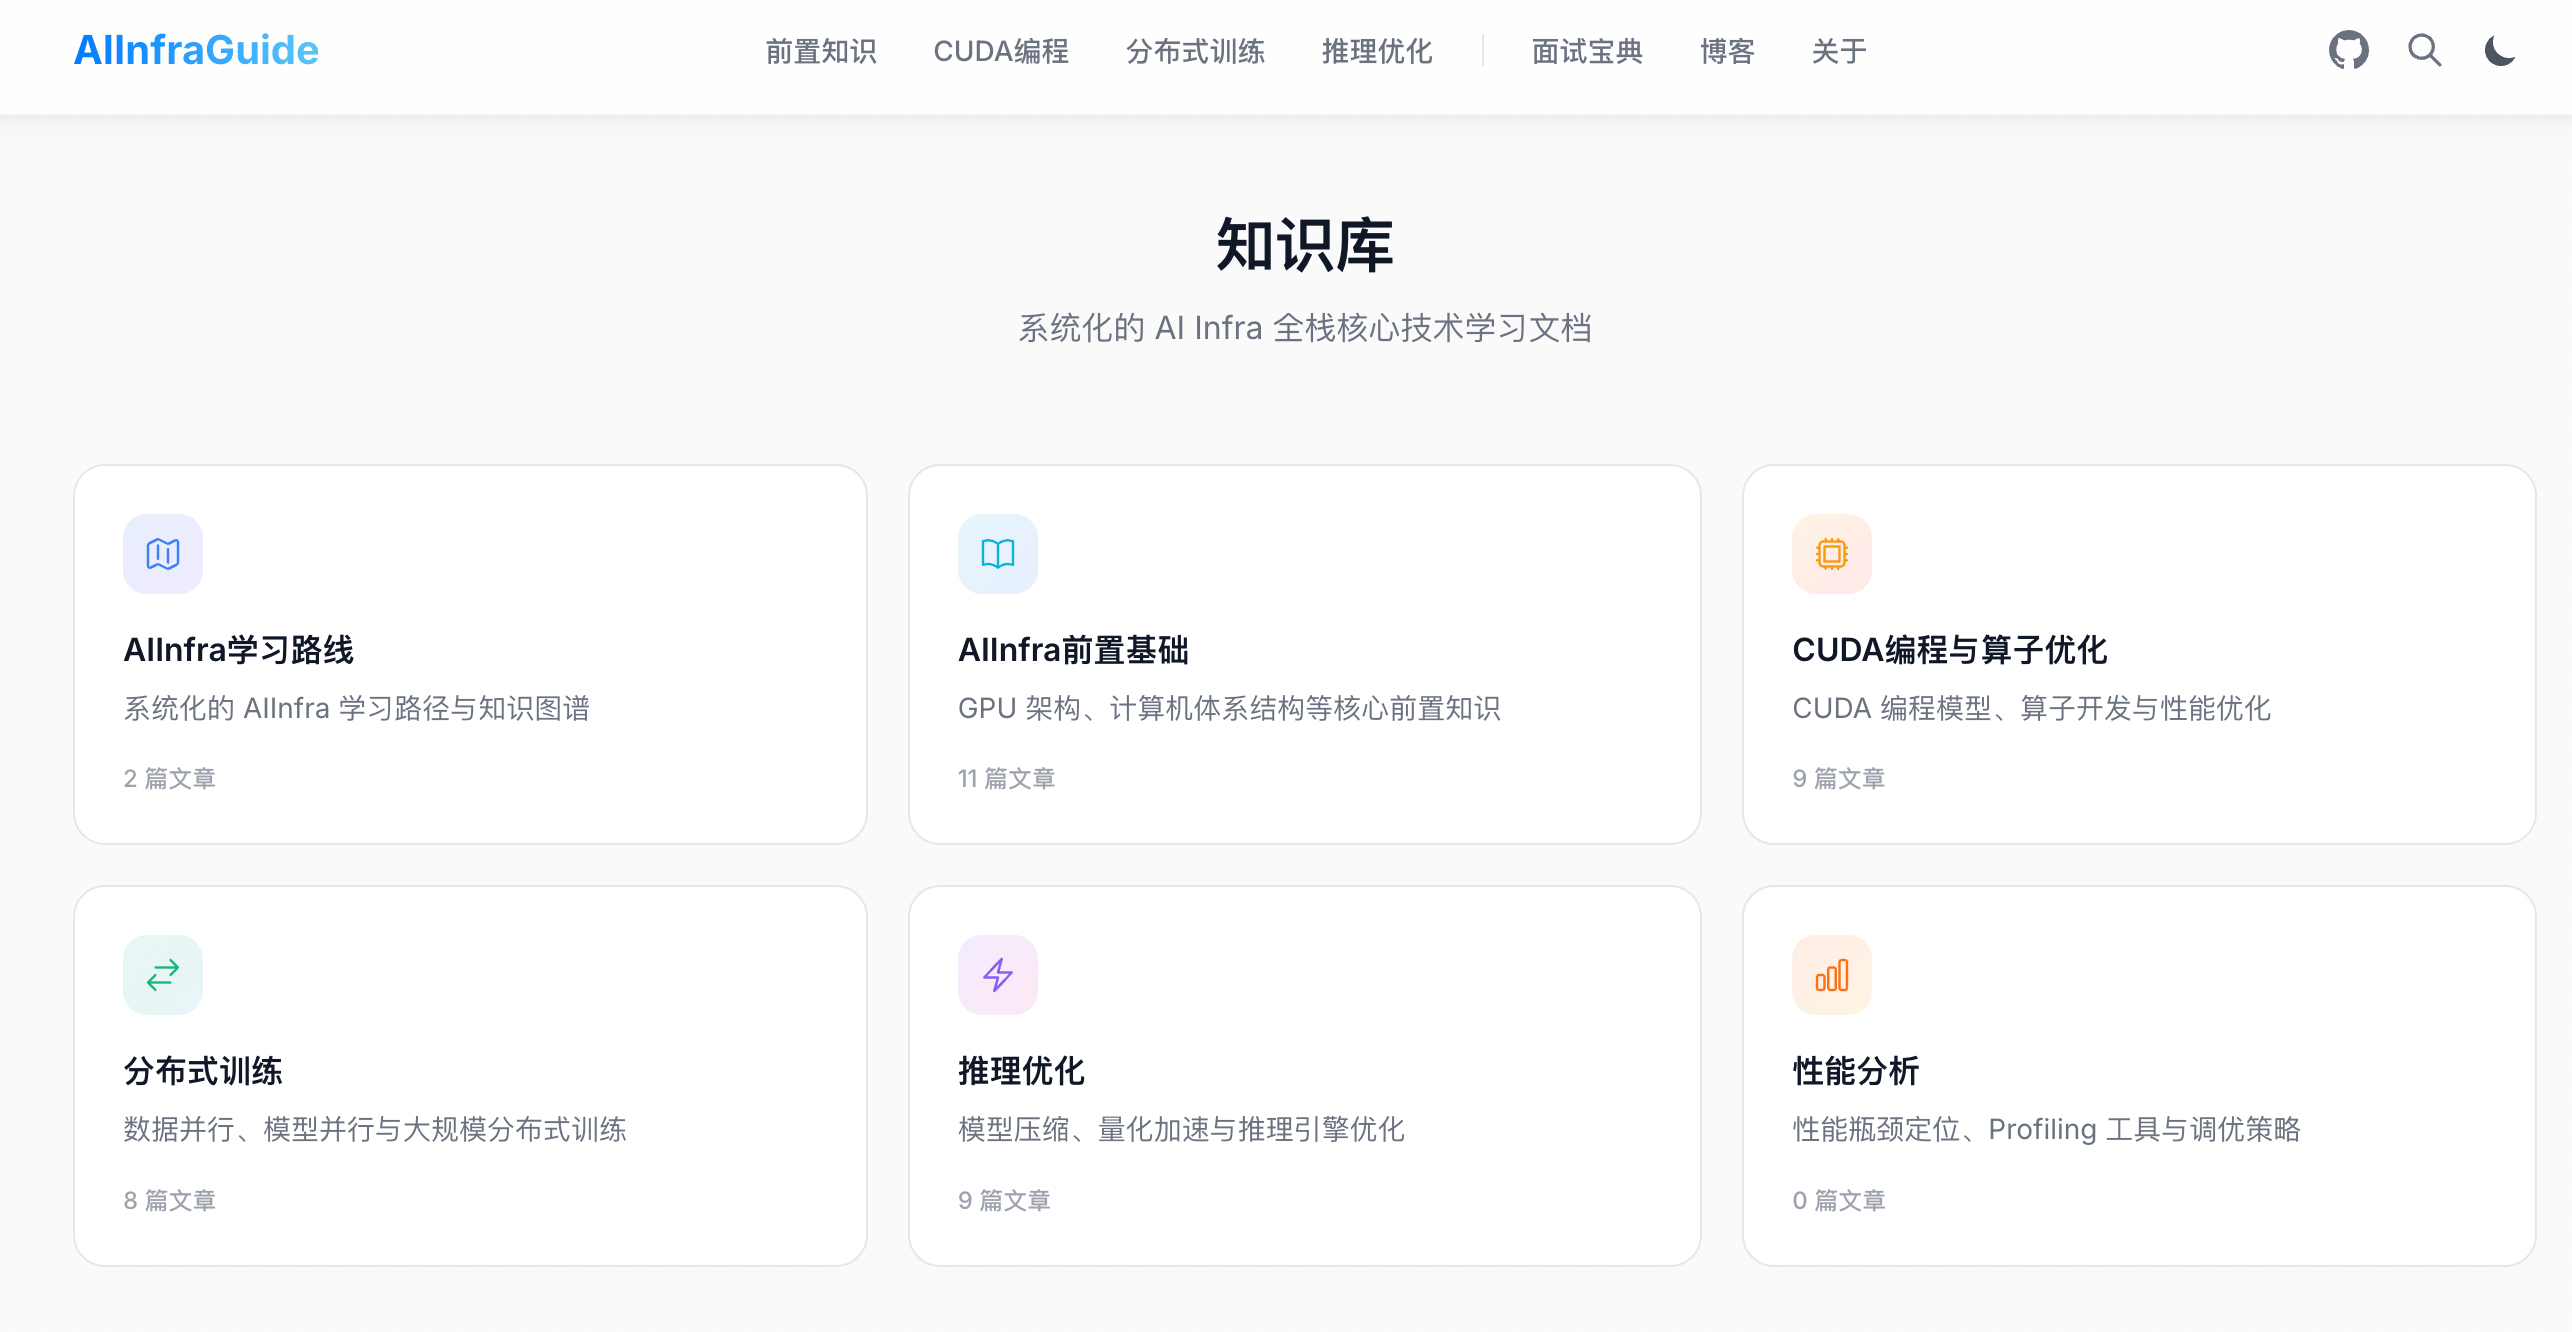
知识库由 学习路线 + 4 大学习模块 + 面试宝典 组成,另有一个规划中的性能分析板块,覆盖 AI Infra 工程师需要掌握的关键技术栈:
| 板块 | 涵盖内容 |
|---|---|
| AIInfra 学习路线 | 系统化的学习路径、知识图谱、推荐资源 |
| 模块一:前置知识 | 编程语言基础、数学基础、Transformer 架构、PyTorch 框架、GPU 硬件概论、集合通信基础 |
| 模块二:CUDA 编程与算子优化 | CUDA 编程入门、性能优化基础、Reduce/GEMM/Softmax/Attention 经典算子实现、AI 编译器、性能分析工具链 |
| 模块三:分布式训练 | 分布式训练总论、集合通信原语、优化器、数据并行(DP/DDP/FSDP)、ZeRO 系列、张量/序列/流水线并行、混合精度、上下文并行、MoE 并行、3D 并行 |
| 模块四:推理优化 | LLM 推理基础、推理引擎核心技术、nano-vllm 源码解读、量化、Speculative Decoding、分布式推理、PD 解耦架构、性能分析与 Benchmark、生产部署、端侧推理 |
| 性能分析(规划中) | Nsight Systems/Compute、Roofline 模型、Profiling 实战 |
| 面试宝典 | 收录 180+ 场面试真题,覆盖 60+ 家公司,按公司梯队分类 |
每篇文章都遵循「先白话后术语」的写作原则——先用通俗的语言解释"是什么、为什么需要",再给出严谨的技术细节,确保读者既看得懂也学得对。
| 序号 | 文章 | 说明 |
|---|---|---|
| 1 | AI Infra 学习路线 | AI Infra 技术栈全貌、系统化学习路径与知识图谱 |
涵盖 GPU 架构、编程语言基础、数学基础、Transformer 架构、PyTorch 框架和集合通信等核心前置知识,为后续深入 AI Infra 打好坚实基础。
| 章节 | 主要内容 |
|---|---|
| 第 1 章 编程语言基础 | Python 进阶、C/C++ 核心、Linux 与开发环境 |
| 第 2 章 数学基础 | 线性代数、概率论与统计、微积分 |
| 第 3 章 Transformer 架构详解 | Self-Attention、前馈网络、位置编码、归一化层、模型架构变种 |
| 第 4 章 PyTorch 框架 | Tensor 与自动微分、Module 与训练流程、调试与性能分析 |
| 第 5 章 GPU 硬件概论 | GPU 架构总览、存储层次、主流 GPU 规格对比、互联拓扑 |
| 第 6 章 集合通信基础 | 通信原语、通信算法、NCCL |
已更新文章:
| 序号 | 文章 | 说明 |
|---|---|---|
| 第 1 章 | 编程语言基础 | Python 工程化与并发、C/C++ 内存管理与构建、Python/C++ 互操作、Linux 与 GPU 软件栈 |
| 第 2 章 | 数学基础 | 线性代数与 GEMM 分块、Softmax/交叉熵/KL 散度、反向传播、数值计算与混合精度 |
| 第 3 章 | 🔥 Transformer 架构:快速入门篇 | Encoder-Decoder 结构、Self-Attention 机制入门 |
| 3.1 | AI Infra 工程师为什么必须懂 Transformer | 从 Infra 视角理解 Transformer 的计算与显存特性 |
| 3.2 | Transformer 全貌及代码实现 | 完整 Transformer 架构拆解与 PyTorch 实现 |
| 3.3 | Self-Attention 机制深入理解 | QKV 与缩放点积、MHA/MQA/GQA/MLA 对比、Causal Mask、计算瓶颈分析 |
| 3.4 | Transformer 前馈网络 FFN 深入理解 | 激活函数与 SwiGLU、中间维度选择、FFN 的张量并行切分、MoE |
| 3.5 | Transformer 位置编码深入理解 | Sinusoidal、可学习位置编码、RoPE、ALiBi 与长上下文扩展 |
| 3.6 | LayerNorm 与残差连接深入理解 | 残差连接、归一化方法全景、Pre-Norm 与 Post-Norm、CUDA 优化视角 |
| 3.7 | Transformer Decoder Block 完整解析 | Decoder-only 选型、完整数据流、PyTorch 实现、参数量/FLOPs/显存手算 |
| 3.8 | 从 Transformer 到 LLM 自回归生成深入理解 | 采样策略、Prefill 与 Decode 阶段、KV Cache 及其优化、推理性能指标 |
| 3.9 | Tokenization 与词嵌入 | 分词算法、从独热编码到 Word Embedding、Transformer 输入层的构造 |
| 第 4 章 | 🔥 PyTorch 框架快速入门篇 | Tensor、autograd、nn.Module、完整训练循环、GPU 训练与性能分析入门 |
| 第 5 章 | 🔥 GPU 基础知识:从硬件架构到 AI 计算 | CPU vs GPU、SM 架构、显存层级、Tensor Core |
| 5.1 | NVIDIA GPU 架构演进:从 Volta 到 Blackwell | V100 → A100 → H100 → B200 架构演进 |
| 第 6 章 | 🔥 集群通信网络与 NCCL:分布式训练的通信骨架 | 通信原语、Ring AllReduce 算法、NCCL 实战 |
从 CUDA 编程入门到经典算子实现(Reduce、GEMM、Softmax、Attention),再到 AI 编译器和性能分析工具链,系统掌握 GPU 编程与算子优化技术。
| 章节 | 主要内容 |
|---|---|
| 第 1 章 CUDA 编程入门 | 开发环境搭建、编程模型、内存模型、第一个实用 Kernel |
| 第 2 章 CUDA 性能优化基础 | Warp 与执行模型、内存访问优化、Occupancy 与资源分配、同步与原子操作 |
| 第 3 章 经典算子实现 - Reduce | 朴素实现、共享内存+树形归约、Warp Shuffle 优化、多级归约 |
| 第 4 章 经典算子实现 - GEMM | 矩阵乘法基础、Shared Memory Tiling、进一步优化、与 cuBLAS 对比 |
| 第 5 章 经典算子实现 - Softmax 与算子融合 | Softmax 数值稳定实现、Online Softmax、算子融合 |
| 第 6 章 Attention 算子 | FlashAttention V1/V2/V3、Decode 阶段加速、PagedAttention CUDA 实现 |
| 第 7 章 AI 编译器 | Triton、torch.compile、TVM/XLA 概述 |
| 第 8 章 性能分析工具链 | Nsight Systems/Compute、PyTorch Profiler |
已更新文章:
| 序号 | 文章 | 说明 |
|---|---|---|
| 快速入门 | 🔥 CUDA 编程快速入门指南 | CUDA 编程模型、线程层级、内存模型与 Kernel 编写 |
| 第 1 章 | CUDA 编程入门 | 开发环境搭建、编程模型、内存模型、第一个实用 Kernel |
| 1.1 | CUDA 开发环境搭建 | 驱动与 Toolkit 安装、nvcc 与 CMake、多版本 CUDA 管理、常见问题排查 |
| 1.2 | CUDA 编程模型 | Grid/Block/Thread 三级线程层次、线程索引计算、Kernel 启动配置 |
| 1.3 | CUDA 内存模型 | 全局、共享、寄存器、常量与统一内存的特性、适用场景与选型 |
| 1.4 | 第一个实用 Kernel:向量加法 | 用向量加法走通 Kernel 编写、主机端代码、错误检查与性能测量 |
| 第 2 章 | CUDA 性能优化基础 | Warp 与执行模型、内存访问优化、Occupancy 与资源分配、同步与原子操作 |
| 2.1 | Warp 与执行模型 | SIMT 执行模型、Warp Divergence、Warp Shuffle 与 Warp 级归约 |
| 2.2 | 内存访问优化 | 全局内存合并访问、Shared Memory Bank Conflict、向量化加载 |
| 2.3 | Occupancy 与资源分配 | SM 资源清单、影响 Occupancy 的三大因素、计算实例与调优策略 |
| 2.4 | 同步与原子操作 | Block 内与 Warp 级同步、Memory Fence、原子操作优化、Cooperative Groups |
| 第 3 章 | 经典算子实现 - Reduce | 朴素实现、共享内存+树形归约、Warp Shuffle 优化、多级归约 |
| 3.1 | CUDA Reduce 算子优化 | 从朴素规约到 Warp Shuffle 与向量化加载,8 个版本逐步优化 |
| 第 4 章 | 经典算子实现 - GEMM | 矩阵乘法基础、Shared Memory Tiling、进一步优化、与 cuBLAS 对比 |
| 4.1 | CUDA GEMM 算子性能优化 | Block/Warp/Thread 三级 Tiling、float4 向量化、Bank Conflict 消除、双缓冲与异步拷贝 |
| 第 5 章 | 经典算子实现 - Softmax 与算子融合 | Softmax 数值稳定实现、Online Softmax、算子融合 |
| 5.1 | CUDA Softmax 朴素实现优化 | Safe Softmax、Warp Shuffle 规约、向量化加载、两遍融合 Kernel |
| 5.2 | CUDA Online Softmax 实现优化 | Online Softmax 推导与 CUDA 实现,FlashAttention 的前置知识 |
| 第 6 章 | Attention 算子 | FlashAttention V1/V2/V3、Decode 阶段加速、PagedAttention CUDA 实现 |
| 6.1 | FlashAttention V1 详解 | Tiling + Online Softmax 把额外显存从 |
| 6.2 | FlashAttention V2 详解 | 调换内外循环、减少非矩阵乘运算、Warp 级工作分配、Causal Mask 优化 |
| 第 7 章 | AI 编译器 | Triton、torch.compile、TVM/XLA 概述 |
| 7.1 | Triton 编程模型 | Triton 编程模型与基础语法,以 Softmax 为例与 PyTorch 实现对比性能 |
从分布式训练总论与集合通信原语出发,深入优化器、数据并行、ZeRO 系列、张量并行、流水线并行、混合精度与显存优化、长序列与上下文并行、MoE 并行,最终通过 3D 并行与混合并行策略串联全部知识。
| 章节 | 主要内容 |
|---|---|
| 第 1 章 分布式训练总论 | 为什么需要分布式训练、训练显存账本、五大并行策略全景、环境搭建与 DDP 启动 |
| 第 2 章 集合通信原语 | AllReduce/ReduceScatter/AllGather/All-to-All 语义、Ring 算法、通信量量化分析 |
| 第 3 章 优化器 | SGD/Adam/AdamW 演进、优化器状态显存开销分析、大 Batch 优化器 LAMB/LARS |
| 第 4 章 数据并行 | DataParallel、DistributedDataParallel、FSDP |
| 第 5 章 ZeRO 系列 | ZeRO-1/2/3 切分策略与通信代价、ZeRO-Offload/Infinity 异构内存卸载 |
| 第 6 章 张量并行与序列并行 | Megatron Column/Row Parallel Linear、通信插入位置、序列并行激活显存优化 |
| 第 7 章 流水线并行 | Bubble 问题本质、GPipe、1F1B、Interleaved 调度 |
| 第 8 章 混合精度与显存优化 | FP16/BF16/FP8 混合精度、梯度累积、Activation Checkpointing |
| 第 9 章 长序列训练与上下文并行 | Attention 的 O(s²) 困境、Ring Attention、DeepSpeed-Ulysses、Megatron Context Parallel |
| 第 10 章 MoE 并行 | Router 机制、Expert Parallelism 的 All-to-All 通信、EP×DP×TP×PP 组合与负载均衡 |
| 第 11 章 3D 并行与混合并行策略 | TP×PP×DP×EP×CP 拓扑设计、通信域映射、rank 编排、集群选型 |
已更新文章:
| 序号 | 文章 | 说明 |
|---|---|---|
| 第 1 章 | 分布式训练总论 | 为什么需要分布式训练、训练显存账本、五大并行策略全景、环境搭建与 DDP 启动 |
| 1.1 | 分布式训练总论:显存账本与五大并行策略全景 | 手算训练显存账本,总览五大并行策略全景与选择原则 |
| 1.2 | 环境搭建与分布式启动 | rank/local_rank/world_size、torchrun 启动与会合机制、NCCL 调试、最小 DDP 脚本 |
| 第 2 章 | 集合通信原语 | AllReduce/ReduceScatter/AllGather/All-to-All 语义、Ring 算法、通信量量化分析 |
| 2.1 | 集合通信原语详解 | AllReduce/ReduceScatter/AllGather/All-to-All 语义、Ring AllReduce 原理、通信耗时量化 |
| 第 3 章 | 优化器 | SGD/Adam/AdamW 演进、优化器状态显存开销分析、大 Batch 优化器 LAMB/LARS |
| 3.1 | 优化器:从 SGD 到 AdamW 与显存开销分析 | 优化器演进、优化器状态显存开销、FP32 主权重的必要性、LARS/LAMB |
| 第 4 章 | 数据并行 | DataParallel、DistributedDataParallel、FSDP |
| 4.1 | 数据并行详解 | DP/DDP/FSDP 演进、梯度同步机制、通信量与显存账本的数学推导 |
| 4.2 | PyTorch 数据并行从原理到实战 | 通信原语、DDP、FSDP 参数分片、多机多卡实战,附完整代码示例 |
以 vLLM 为贯穿主线,覆盖 LLM 推理基础、推理引擎核心技术、nano-vllm 源码解读、量化、Speculative Decoding、分布式推理、PD 解耦架构、生产级服务特性、性能分析、生产部署运维,以及端到端选型实战。
| 章节 | 主要内容 |
|---|---|
| 第 1 章 LLM 推理基础 | Prefill/Decode 两阶段、KV Cache、性能指标、Roofline 瓶颈分析、推理链路 |
| 第 2 章 推理引擎核心技术 | PagedAttention、Continuous Batching、Prefix Cache、Chunked Prefill、Attention 后端与图优化 |
| 第 3 章 nano-vllm 源码解读 | 以约 1200 行极简引擎 nano-vllm 为主线,逐模块读懂连续批处理、PagedAttention、FlashAttention、张量并行与 CUDA Graph |
| 第 4 章 量化 | 量化基础、SmoothQuant、GPTQ/AWQ、FP8、NVFP4/MXFP4、KV Cache 量化 |
| 第 5 章 Speculative Decoding | Draft+Verify 原理、N-gram/Suffix、Medusa/EAGLE/MTP、vLLM 投机解码实战 |
| 第 6 章 分布式推理与大模型部署 | 张量并行、流水线并行、数据/专家并行、Ray 多节点、vLLM 分布式部署 |
| 第 7 章 PD 解耦架构 | 混合 Batching 干扰、DistServe/Splitwise、KV Cache 传输、Goodput 与 SLO 调度 |
| 第 8 章 性能分析与 Benchmark | 推理指标体系、vllm bench/GenAI-Perf、Nsight、性能回归门禁 |
| 第 9 章 生产部署与运维 | 容器化与 K8s 部署、可观测性、自动扩缩容、负载均衡、容量规划 |
| 第 10 章 端侧推理 | 端侧软硬件栈、异构执行、运行时选型、量化、内存优化与 Benchmark |
已更新文章:
| 序号 | 文章 | 说明 |
|---|---|---|
| 第 1 章 | LLM 推理基础 | Prefill/Decode 两阶段、KV Cache、性能指标、Roofline 瓶颈分析、推理链路 |
| 1.1 | LLM 推理基础 | Prefill/Decode 两阶段、KV Cache 显存账本、TTFT/TPOT 指标,用 Roofline 解释 Decode 为何 Memory Bound |
| 1.2 | vLLM 快速入门 | 从安装到部署你的第一个 LLM 推理服务,离线批量推理与在线 OpenAI 兼容服务 |
| 第 2 章 | 推理引擎核心技术 | PagedAttention、Continuous Batching、Prefix Cache、Chunked Prefill、Attention 后端与图优化 |
| 2.1 | PagedAttention | 借鉴虚拟内存分页思想,用 Block Table 消除 KV Cache 碎片化,支持前缀共享与 Copy-on-Write |
| 2.2 | Continuous Batching | Iteration-level Scheduling 让请求随到随拼、完成即退,把 GPU 利用率从三成拉到八成以上 |
| 2.3 | Prefix Cache 与 RadixAttention | vLLM 基于 Hash 的自动前缀缓存,SGLang 用 Radix Tree 做更高效的前缀共享 |
| 2.4 | Chunked Prefill 与统一调度 | 切块 Prefill 消除对 Decode 的干扰,vLLM V1 用统一 Token 预算调度器抹平 Prefill/Decode 边界 |
| 2.5 | Attention 后端与图优化 | 可插拔 Attention 后端与 CUDA Graph、torch.compile 消除 Decode 阶段的 CPU 启动开销 |
| 第 3 章 | nano-vllm 源码解读 | 以约 1200 行极简引擎 nano-vllm 为主线,逐模块读懂连续批处理、PagedAttention、FlashAttention、张量并行与 CUDA Graph |
| 3.1 | 项目全景与四层架构 | nano-vllm 定位、目录结构,与接口/引擎/调度/执行四层架构及端到端数据流 |
| 3.2 | 配置、入口与一次 generate 的全流程 | Config/SamplingParams、LLM 对 LLMEngine 的封装,以及 generate→add_request→step→postprocess 主循环 |
| 3.3 | 模型骨架与核心算子 | RMSNorm/RoPE/SwiGLU、并行 Linear 族与张量并行、词表并行 Embedding/LMHead、Attention 两条路径 |
| 3.4 | KV Cache 与 BlockManager | Block 结构、PagedAttention 分块、基于 xxhash 的前缀缓存、块的分配回收与 Sequence 状态机 |
| 3.5 | Scheduler 与连续批处理 | Waiting/Running 双队列、Prefill/Decode 分离调度、Token Budget、chunked prefill 与抢占重算 |
| 3.6 | ModelRunner、CUDA Graph 与性能基准 | 序列张量化、全局 Context、KV Cache 显存切分、CUDA Graph 捕获回放,以及官方基准与 vLLM 对比 |
| 第 4 章 | 量化 | 量化基础、SmoothQuant、GPTQ/AWQ、FP8、NVFP4/MXFP4、KV Cache 量化 |
| 4.1 | 量化基础 | Scale 与零点、对称与非对称、位宽与格距、量化粒度、校准与 PTQ/QAT |
| 4.2 | W8A8 与 SmoothQuant | 激活离群值、等价缩放与迁移强度 α、INT8 GEMM、LLM Compressor 配方 |
| 4.3 | Weight-only INT4 | GPTQ 误差补偿、AWQ 激活感知缩放、Marlin 融合 Kernel 与 vLLM 的 Kernel 选择 |
| 4.4 | KV Cache 量化 | KIVI 分组与残留缓存、FP8 KV 的 Scale 校准与跳层、长上下文验证 |
| 4.5 | FP8 与 NVFP4/MXFP4 | E4M3/E5M2、FP8 Scale、E2M1 微块缩放、NVFP4 与 MXFP4 对比及硬件执行条件 |
| 4.6 | 量化选型与 vLLM 实战 | 基于 v0.32.0 的按瓶颈选型、在线量化入口、FP16/AWQ 吞吐与生成质量对照 |
| 第 5 章 | Speculative Decoding | Draft+Verify 原理、N-gram/Suffix、Medusa/EAGLE/MTP、vLLM 投机解码实战 |
| 5.1 | 投机解码核心原理 | Draft + Verify、接受与残差采样的保分布证明、one-hot Draft、KV 回退 |
| 5.2 | Draft 模型与无模型方案 | 独立 Draft 与 PARD、Tokenizer 兼容、N-gram/Suffix、接受率与候选覆盖 |
| 5.3 | Medusa、EAGLE 与 MTP | 多头预测、Tree Attention、EAGLE-2/3、DeepSeek-V3 MTP、Block Verification |
| 5.4 | 收益边界与限制 | 提交长度与轮耗时账本、投机长度递减、Dynamic SD、并发、量化与流式延迟 |
| 5.5 | vLLM 投机解码实战 | 基于 v0.32.0 的基线/N-gram/Draft/EAGLE-3 对照、逐请求接受指标与 Benchmark |
| 第 10 章 | 端侧推理 | 端侧软硬件栈、异构执行、运行时选型、量化、内存优化与 Benchmark |
| 10.1 | 端侧推理基础:从模型导出到异构硬件执行 | 端侧约束、软硬件栈、运行时选型、量化与内存优化、Benchmark,以及 ExecuTorch/XNNPACK 最小实例 |
共收录 180+ 场面试真题,覆盖 60+ 家公司,按梯队分类组织。在线浏览 →
涵盖公司包括字节跳动、阿里巴巴、腾讯、百度、快手、美团、蚂蚁、英伟达、MiniMax、蔚来、小鹏、理想等。
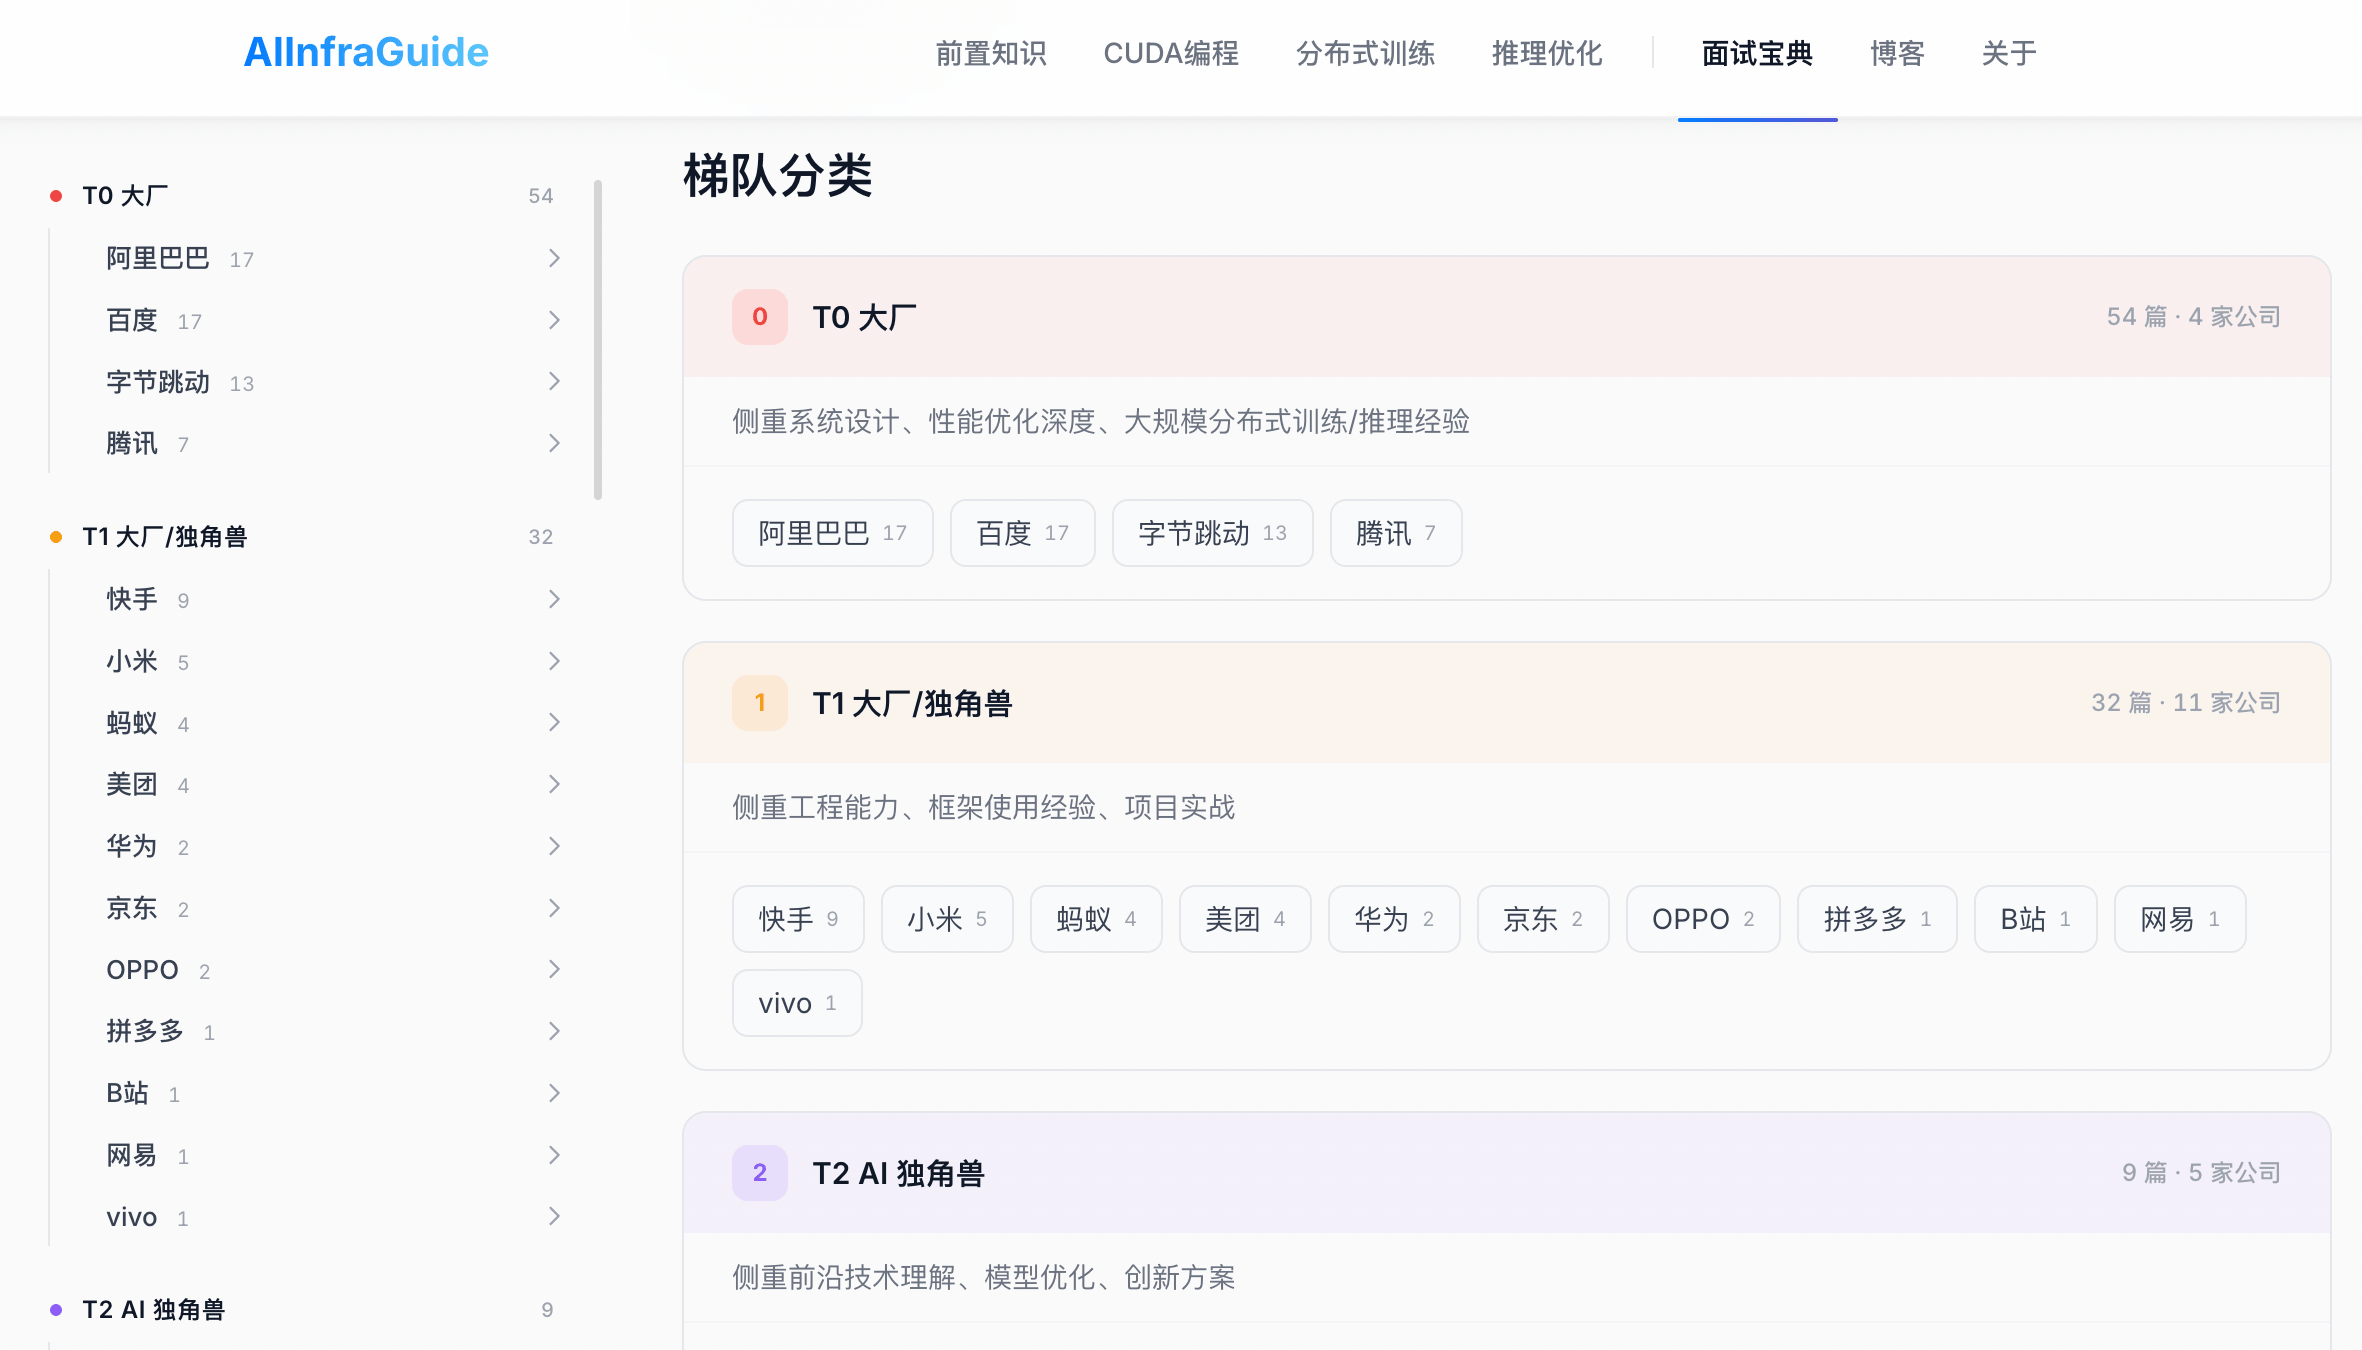
投递总览:
| 梯队 | 公司 | 主要 AI Infra 岗位 |
|---|---|---|
| T0 大厂 | 字节跳动、阿里巴巴、腾讯、百度 | AI Infra 工程师、高性能计算研发、推理优化工程师、分布式训练框架 |
| T1 大厂/独角兽 | 快手、小米、美团、蚂蚁、京东、拼多多、OPPO、华为 | AI Infra、高性能计算、大模型推理优化、AI 平台开发 |
| T2 AI 独角兽 | MiniMax、阶跃星辰、智谱AI、面壁智能、月之暗面 | AI Infra、大模型算法 (偏 Infra)、推理系统开发、Agent Infra |
| T3 芯片/硬件厂商 | 英伟达、摩尔线程、海光、寒武纪、壁仞科技、飞腾 | 算子开发、CUDA 优化、GPU 软件工程师、AI 编译器、高性能计算 |
| T4 自动驾驶/车企 | 小鹏汽车、蔚来、理想、卓驭(大疆车载)、小马智行、元戎启行 | AI Infra、高性能计算、大模型推理优化、AI 平台 |
| T5 其他 | 科大讯飞、网易、海康威视、联想、猿辅导、好未来等 | AI Infra、高性能计算、推理引擎开发、大模型算法 |
注:分布式训练相关的岗位特别少,一般只有做大模型的大厂才有,所以大家在求职准备过程中,可以重点关注算子优化、推理优化、推理框架这类岗位,训练相关的技术点了解即可,不必深钻。
| 梯队 | 考察侧重 |
|---|---|
| T0 大厂(字节/阿里/腾讯/百度) | 结构化面试 2-3 轮,项目深挖 + 模型架构 + 推理/训练优化 + C++ 八股 + LeetCode Medium |
| T1 大厂/独角兽(快手/美团/蚂蚁等) | 与 T0 类似,推理优化问得多,部分公司重视系统设计 |
| T2 AI 独角兽(MiniMax/阶跃/智谱) | 偏研究导向,深挖 MoE 路由优化、RLHF 细节、前沿 paper,传统八股较少 |
| T3 芯片/硬件(英伟达/壁仞/寒武纪) | 重 GPU 架构、CUDA 编程、HPC 基础,手写 kernel 频率最高 |
| T4 车企/自动驾驶(蔚来/大疆车载/小鹏) | 重 C++ 功底、推理部署(TensorRT/TVM/量化)、边缘实时性能,LLM 问得少 |
| T5 其他(海康/科大讯飞等) | 难度适中,C++ 和推理部署为主 |
投递时间线:
| 时间段 | 投递策略 |
|---|---|
| 3-4月 | 暑期实习提前批(字节、阿里、腾讯、快手) |
| 5-6月 | 暑期实习正式批 + 日常实习(美团、拼多多、中小厂) |
| 7-8月 | 秋招提前批(字节 AML、百度、华为) |
| 9-10月 | 秋招正式批(全面投递) |
| 11-12月 | 秋招补录 + 春招准备 |
| 次年2-4月 | 春招(HC 较少,竞争激烈) |
AIInfraGuide 是一个开源项目,欢迎通过以下方式参与共建:
- 提交 Issue:发现错误、提出建议,或者告诉我们你希望看到的主题
- 贡献 PR:分享你的实践经验、补充技术细节、改进现有内容
- Star & Share:如果觉得有帮助,请在 GitHub 上给个 Star,让更多人发现这个项目
💡 提示:如果你不确定从哪里开始,推荐先阅读知识库中的「AIInfra 学习路线」,它会帮你梳理一条清晰的学习路径。
让我们一起构建 AI Infra 社区的知识基础设施。
欢迎通过以下方式与我交流:
- 公众号:《AI Infra Guide》
- 知乎:草帽路飞
- 社群:微信 caomaolufei2026

MIT